

 Tin tức
 Thông tin Coin
 Về chúng tôi


GPT-6 Astra đạt điểm trung bình 69,4 trong bài đánh giá gồm 8 nhiệm vụ với cánh tay robot thực tế, cao nhất trong 5 mô hình ngôn ngữ được thử nghiệm. Hầu hết mô hình mất khoảng 30 phút cho mỗi nhiệm vụ, trong khi con người hoàn thành cùng nhiệm vụ trong trung bình 20 giây — chênh lệch tốc độ được đánh giá là khoảng 100 lần.
Artificial Analysis công bố bản xem trước nghiên cứu AA-Robotics v0.1 ngày 14 tháng 10 năm 2026. Bài đánh giá cho các mô hình ngôn ngữ trong môi trường tác nhân lập trình điều khiển cánh tay robot, nhằm đo khả năng hiểu, lập kế hoạch và hành động trong môi trường vật lý.
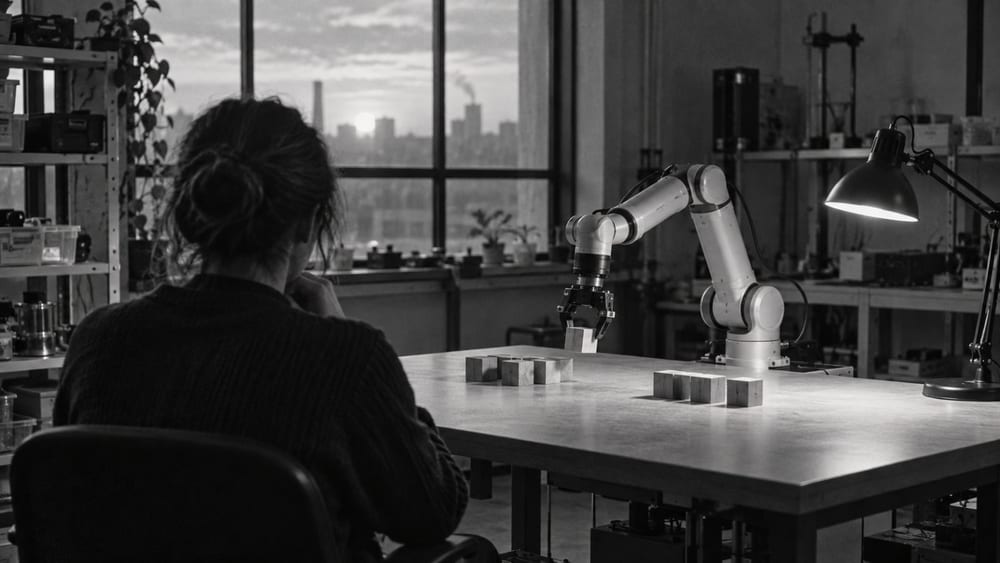
Mô hình viết mã trong tác nhân lập trình rồi gửi lệnh điều khiển cánh tay robot qua HTTP API. Ba camera quanh bàn và một camera gắn ở cổ tay robot cung cấp hình ảnh môi trường. Các mô hình thử thực hiện nhiệm vụ mà không được huấn luyện trước cho từng nhiệm vụ.
Danh sách gồm 8 nhiệm vụ như nhấn nút, di chuyển đồ chơi, rót nước, sắp xếp khối, viết chữ và đo hộp. Mô hình quan sát vị trí đồ vật cùng môi trường qua camera trước khi quyết định chuyển động. Tất cả nhiệm vụ đều là thao tác trên bàn bằng một cánh tay robot.
Điểm số không phải tỷ lệ hoàn thành nhiệm vụ. Mỗi nhiệm vụ hoàn thành được 100 điểm; nếu chỉ hoàn thành một phần, mô hình nhận điểm tương ứng với mức độ tiến triển. Điểm trung bình được tính từ kết quả của 8 nhiệm vụ. Vì vậy, 69,4 điểm của GPT-6 Astra không có nghĩa là mô hình hoàn thành 69,4% số nhiệm vụ.
GPT-6 Astra dẫn đầu với 69,4 điểm. GPT-6.1 Sol đạt 64,6 điểm, Gemini 4 Argon đạt 55,3 điểm, Claude Opus 5.5 đạt 48,8 điểm và Claude Fable 5.1 đạt 46,3 điểm.
Kết quả khác nhau tùy nhiệm vụ. Cả 5 mô hình đều đạt điểm tối đa ở phần nhấn nút và đặt đồ chơi, nhưng không mô hình nào đạt điểm tối đa khi đo hộp. Điểm tổng hợp do đó chưa thể hiện đầy đủ hiệu suất của mô hình ở từng loại thao tác.
Bốn trong số 5 mô hình mất khoảng 30 phút cho mỗi nhiệm vụ. Gemini 4 Argon mất trung bình 52 phút, trong khi con người cần trung bình 20 giây cho cùng nhiệm vụ. Đơn vị đánh giá cho biết chênh lệch tốc độ giữa mô hình và con người vào khoảng 100 lần.
Nhật ký thực thi cho thấy mô hình dành thời gian ban đầu để nhận biết cánh tay robot và khung cảnh xung quanh, đồng thời lập kế hoạch cho bước tiếp theo giữa các chuyển động. Tổng thời gian bao gồm cả việc diễn giải môi trường và quyết định hành động, bên cạnh thời gian cánh tay robot thực sự di chuyển.
Kết quả gắp vật thể được thống kê riêng với điểm tổng hợp. Trong 6 nhiệm vụ gắp vật thể, tỷ lệ thành công theo từng lần thử của GPT-6 Astra là 45%, còn GPT-6.1 Sol là 28%. Đây là số liệu về các lần thử gắp vật thể, khác với điểm trung bình của 8 nhiệm vụ và tỷ lệ hoàn thành toàn bộ bài đánh giá.
Các mô hình cũng sử dụng công cụ lập trình khác nhau: nhóm GPT chạy trên Codex, nhóm Claude trên Claude Code, còn Gemini 4 Argon chạy trên Antigravity. Vì vậy, khó quy toàn bộ chênh lệch điểm số cho năng lực riêng của mô hình ngôn ngữ.
Trong thảo luận công khai trên cộng đồng r/singularity của Reddit, một số ý kiến đánh giá cao việc mô hình thực hiện được các nhiệm vụ vật lý đơn giản. Những ý kiến khác cho rằng còn quá sớm để gọi đây là kỷ nguyên AI hiện thân, do tốc độ chậm và công nghệ vẫn ở giai đoạn nghiên cứu. Cũng có ý kiến đề nghị đánh giá mô hình trong môi trường thực tế phức tạp hơn. Đây là phản ứng của một bộ phận cộng đồng công khai, không đại diện cho toàn ngành.
Kết quả cho thấy mô hình ngôn ngữ có thể quan sát môi trường vật lý bằng camera, điều khiển cánh tay robot qua mã và thực hiện các nhiệm vụ giới hạn trên bàn. Tuy nhiên, bài đánh giá chỉ dùng một loại cánh tay robot và 8 nhiệm vụ, nên riêng điểm số này chưa đủ để đánh giá hiệu suất trong môi trường sản xuất.

Bình luận 0