

 News
 Coin Information
 About us


 Add as a preferred source on Google
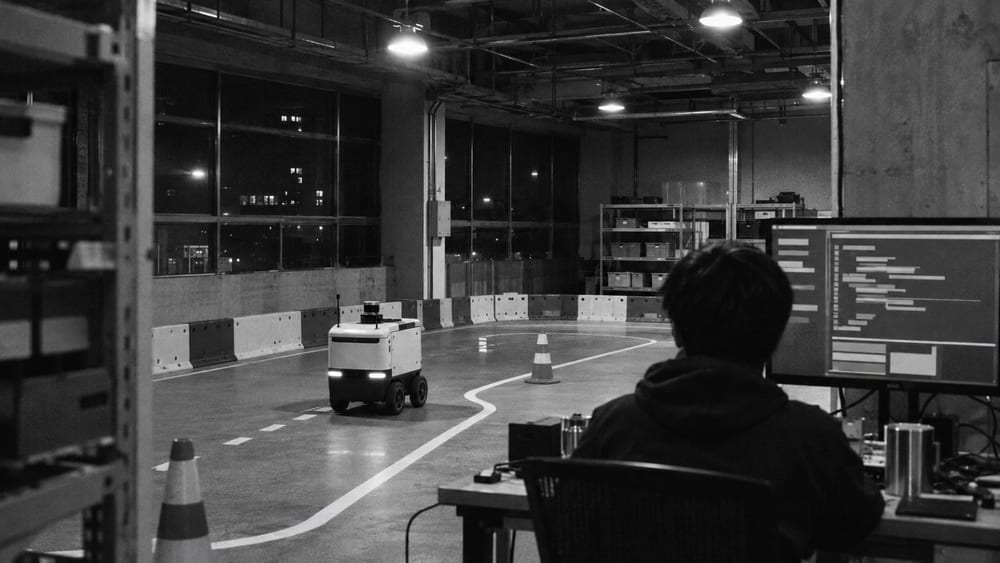
Artificial Analysis đã tăng số tác vụ trong bài đánh giá tác nhân lập trình từ 290 lên 322. Phiên bản mới bổ sung tác vụ cho bài kiểm tra sửa đổi kho mã nguồn và thay bộ kiểm định chấm điểm của bài kiểm tra thao tác dòng lệnh.
Trong tài liệu phương pháp luận Chỉ số đánh giá tác nhân lập trình v2.1, được công khai tính đến ngày 14, Artificial Analysis cho biết điểm của ba bài thi được tổng hợp với trọng số ngang nhau. Cách tính này khác với việc gộp điểm tất cả tác vụ rồi lấy trung bình: bài thi có nhiều tác vụ hơn không được tính trọng số cao hơn.
Phiên bản v2.1 gồm 132 tác vụ của FrontierCode-AA 2.0, đánh giá khả năng sửa đổi kho mã nguồn mở; 66 tác vụ của Terminal-Bench 4.1, kiểm tra các công việc nhiều bước trong môi trường dòng lệnh; và 124 tác vụ của SWE-Atlas-QnA-AA, đánh giá khả năng đọc kho mã nguồn và trả lời câu hỏi. Tổng cộng có 322 tác vụ.
Mỗi tác vụ được đánh giá dựa trên kết quả của ba lần thử. Chỉ số phản ánh thành tích của tác nhân AI trên nhiều loại công việc, thay vì chỉ đo tỷ lệ trả lời đúng của một mô hình đơn lẻ.
Số tác vụ tăng do bài thi FrontierCode được cập nhật. FrontierCode v1.1 trong v2.0 có 100 tác vụ, còn FrontierCode-AA 2.0 trong v2.1 có 132 tác vụ. Số tác vụ của hai bài thi còn lại không đổi, nên toàn bộ mức tăng 32 tác vụ đến từ bài thi này.
FrontierCode-AA 2.0 đánh giá liệu những thay đổi được áp dụng vào kho mã nguồn mở thực tế có đủ tiêu chuẩn để người duy trì kho mã chấp nhận hợp nhất hay không. Tác vụ sẽ nhận 0 điểm nếu không vượt qua các kiểm tra bắt buộc hoặc nếu tác nhân tìm và sử dụng đoạn mã đáp án có sẵn từ bên ngoài.
Terminal-Bench 4.1 giữ nguyên 66 tác vụ và môi trường thực thi như phiên bản 4.0, nhưng cập nhật bộ kiểm định. Quy trình chấm điểm mã do tác nhân thực hiện các công việc nhiều bước trên dòng lệnh đã được sửa đổi.
Trong quá trình chấm điểm, mã do tác nhân viết được chạy dưới dạng một tiến trình riêng có quyền hạn thấp. Các điều kiện kiểm định từng khiến một số lời giải đúng bị đánh trượt cũng đã được sửa.
Trong thông báo phát hành phiên bản 4.1, nhóm Terminal-Bench cho biết họ đã cải thiện bộ kiểm định và chấm lại các kết quả lưu từ phiên bản 4.0 bằng bộ kiểm định mới. Vì vậy, giữa hai phiên bản có khác biệt cả về số tác vụ lẫn cách chấm điểm.
SWE-Atlas-QnA-AA gồm 124 tác vụ, đánh giá khả năng đọc mã trong kho lưu trữ và trả lời câu hỏi thay vì trực tiếp chỉnh sửa mã. Số tác vụ của bài thi này không đổi giữa v2.0 và v2.1.
Artificial Analysis cũng điều chỉnh cách tính chi phí cho mỗi tác vụ. Phương pháp mới kết hợp lượng token do nhà cung cấp mô hình báo cáo với số liệu thực đo về tỷ lệ truy cập bộ nhớ đệm thường thấy. Do các tác vụ đánh giá và một số công thức chấm điểm, tính chi phí đã thay đổi, chênh lệch điểm giữa hai phiên bản khó có thể chỉ được xem là thay đổi về năng lực mô hình.
Mỗi mục trên bảng xếp hạng công khai đại diện cho một cấu hình tác nhân, gồm cả thiết lập suy luận và công cụ thực thi, chứ không chỉ là một mô hình. Cùng một mô hình có thể đạt điểm khác nhau tùy công cụ và thiết lập được sử dụng.
Tài liệu phương pháp luận mô tả v2.1. Bảng xếp hạng công khai tính đến ngày 14 hiển thị v2.1 cùng ba cấu hình đánh giá.
Trước đó, TokenPost từng đưa tin về lần cải tổ chỉ số v1.4, trong đó tiêu chí đánh giá chấm 0 điểm cho các nỗ lực khai thác phần thưởng được áp dụng. Tiếp nối thay đổi đó, v2.1 cập nhật các tác vụ sửa mã và bộ kiểm định chấm điểm cho công việc dòng lệnh.

Comment 0