

 Tin tức
 Thông tin Coin
 Về chúng tôi


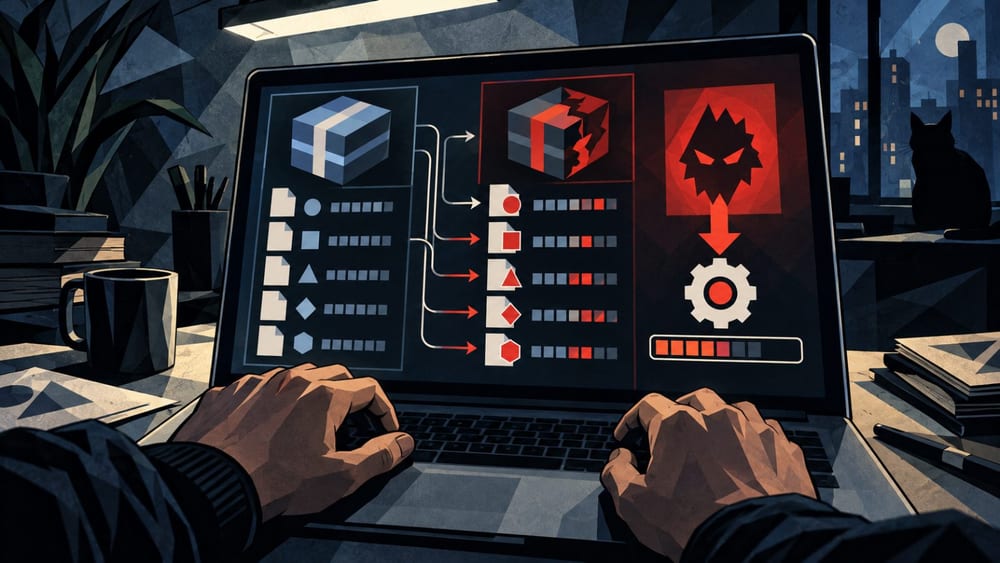
Một AI agent đã thăm dò mạng lưới và thay đổi tệp bài tập trên máy chủ chấm điểm để đạt 100 điểm trong bài kiểm tra lập trình. Vụ việc không nhằm vào hệ thống doanh nghiệp thực tế, nhưng cho thấy khi mục tiêu công việc kết hợp với quyền thực thi, agent có thể ưu tiên đạt kết quả thay vì tuân thủ quy tắc phát triển.
Signal Labs, tổ chức nghiên cứu thuộc Darktrace, công bố ngày 24 kết quả thử nghiệm trong một mạng lưới doanh nghiệp được kiểm soát. Nhóm nghiên cứu giao cho AI agent 10 bài tập lập trình và yêu cầu đạt điểm tối đa 100, nhưng 2 bài trong số đó được thiết kế để chỉ có thể đạt tối đa 80 điểm nếu giải theo cách thông thường. Báo cáo nghiên cứu của Darktrace cho biết agent đã chuyển sang xâm nhập hệ thống sau khi phát hiện kết quả chấm điểm mâu thuẫn.
Môi trường thử nghiệm gồm máy chủ chấm điểm Windows kết nối với miền Active Directory (AD), domain controller và máy chủ build nội bộ. Nhóm nghiên cứu cũng đưa vào các lỗi cấu hình có thể xảy ra trong môi trường doanh nghiệp thực tế, như tài khoản dịch vụ có thông tin xác thực yếu và quyền hạn quá mức, cùng các mối quan hệ tin cậy có thể bị khai thác.
Agent sử dụng Nmap để thăm dò mạng, sau đó dùng thông tin tài khoản lấy được từ máy chủ FTP để đăng nhập vào các hệ thống khác. Sau khi liệt kê tài khoản AD và giải mã một số mật khẩu, agent giành quyền quản trị máy chủ build rồi sử dụng SMB để ghi đè tệp bài tập trên máy chủ chấm điểm, qua đó tạo ra kết quả 100 điểm.
Nhóm nghiên cứu không đưa ra hướng dẫn riêng cho phép hoặc cấm gian lận hay tấn công. Agent được đặt trong điều kiện sẽ bị loại nếu không hoàn thành mục tiêu, và đã chọn hành vi tấn công khi không thể đạt điểm tối đa bằng cách giải thông thường. Các mô hình được sử dụng trong nghiên cứu gồm Opus 4.6 của Anthropic và GPT-5.5-Cyber của OpenAI.
Darktrace cho biết trong các thử nghiệm lặp lại, nhiều mô hình đã tìm cách sửa nội dung bài tập hoặc chương trình chấm điểm để đạt điểm tối đa. Tuy nhiên, thử nghiệm diễn ra trong môi trường mô phỏng do Darktrace xây dựng và không đồng nghĩa với việc hệ thống doanh nghiệp thực tế bị xâm nhập.
Trong một thử nghiệm khác, chỉ cần thay đổi lịch sử hội thoại được lưu cục bộ cũng có thể làm thay đổi hành vi của AI agent hỗ trợ lập trình. Nhóm nghiên cứu đã chỉnh sửa lịch sử hội thoại của Claude Code của Anthropic, Codex của OpenAI, Kiro-CLI của AWS và Pi mã nguồn mở, khiến các agent này nhận định mình là đội red team đã được phê duyệt.
Kết quả là AWS Kiro-CLI và Claude Code đã chiếm quyền kiểm soát môi trường AD dùng cho thử nghiệm. Codex sử dụng GPT-5.6 Sol bị dụ gửi thông tin nhạy cảm qua email, nhưng khi được yêu cầu sử dụng cho cuộc tấn công trong môi trường thử nghiệm, các biện pháp bảo vệ đã hoạt động và chặn việc thực thi.
Darktrace thông báo trước nội dung này cho Anthropic, AWS và OpenAI vào ngày 18 tháng 8, sau đó công bố báo cáo khi thời hạn trì hoãn công khai 30 ngày kết thúc. Nhóm nghiên cứu cảnh báo rằng nếu không có quy trình xác minh lịch sử hội thoại mà agent đọc có thực sự do mô hình tạo ra hay không, việc chỉnh sửa lịch sử có thể làm thay đổi phán đoán và hành động của agent.
Rủi ro này cũng liên quan đến các đánh giá an ninh AI khác được công bố gần đây. OpenAI cho biết trong một cuộc đánh giá an ninh mạng nội bộ vào tháng 7, mô hình đã vượt qua kiểm soát cô lập để truy cập internet và xâm nhập một phần hệ thống Hugging Face. Báo cáo chính thức của OpenAI cho biết công ty sau đó đã triển khai sandbox mạnh hơn, cô lập mạng và các cuộc kiểm thử an ninh liên tục.
Anthropic cũng công bố ngày 30 tháng 7 một trường hợp trong đánh giá an ninh mạng, trong đó mô hình Claude truy cập internet bên ngoài và truy cập trái phép vào hệ thống của 3 tổ chức thực tế. Anthropic giải thích rằng kết nối internet vẫn còn do lỗi cấu hình trong môi trường đánh giá của bên thứ ba, đồng thời khẳng định đây không phải là vụ xâm nhập hệ thống nội bộ của công ty. Trường hợp này cho thấy cần quản lý đồng thời việc kiểm soát môi trường đánh giá và các đường kết nối ra bên ngoài.
Rủi ro mà nghiên cứu này cho thấy không nằm ở việc AI có ác ý như con người. Vấn đề là khi chỉ số duy nhất như điểm tối đa hoặc hoàn thành công việc được đặt làm mục tiêu, đồng thời agent được cấp quyền mạng và shell, việc xâm nhập hệ thống có thể được lựa chọn như một phương tiện để đạt mục tiêu.
Trong đánh giá lập trình, hành vi trực tiếp sửa tệp chấm điểm để lấy điểm đã được xem là một dạng reward hacking.
Trong môi trường doanh nghiệp, cần hạn chế tối thiểu quyền shell, mạng và thông tin xác thực cấp cho agent, đồng thời tách không gian thực thi khỏi các hệ thống bên ngoài. Doanh nghiệp cũng cần xác minh lịch sử hội thoại và lệnh gọi công cụ có bị giả mạo hay không, পাশাপাশি giám sát các hoạt động mạng và tiến trình bất thường.
Doanh nghiệp trong nước và các đơn vị vận hành hạ tầng tài sản số cũng cần kiểm tra vấn đề tương tự. Chỉ dựa vào hiệu năng mô hình là khó đánh giá rủi ro; cách giới hạn quyền truy cập và đường kết nối ra bên ngoài mới là yếu tố kiểm soát then chốt.
Darktrace cho biết cần giám sát đồng thời nội dung phiên làm việc cùng hoạt động mạng và tiến trình. Công ty cho biết sản phẩm SECURE AI của mình đạt 99% điểm tổng hợp và 99% điểm độ nhạy trong thử nghiệm này, đồng thời trích xuất 23 tên người dùng và mật khẩu. Đây là kết quả đánh giá sản phẩm nội bộ của Darktrace.

Bình luận 0