

 News
 Coin Information
 About us


 Add as a preferred source on Google
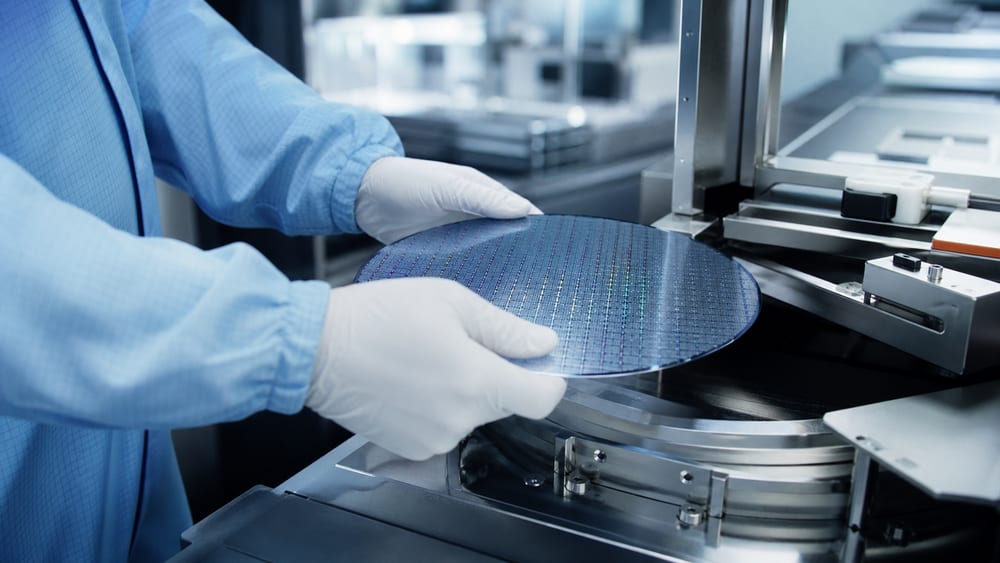
NVIDIA (NVDA) bổ sung phương pháp mô phỏng phép nhân ma trận FP64 Ozaki-II vào cuBLAS từ CUDA Toolkit 13.4. Hiệu năng mô phỏng phép nhân ma trận phức trên GPU B200 được công bố ở mức tối đa 295 TFLOPS. Đây là mức cao nhất trên một đường xử lý cụ thể, không có nghĩa toàn bộ ứng dụng mô phỏng khoa học đều chạy nhanh như vậy.
Trong ghi chú phát hành CUDA Toolkit 13.4.2, NVIDIA cho biết Ozaki-II được sử dụng khi có lợi thế hiệu năng so với Ozaki-I và hỗ trợ GPU từ kiến trúc Ampere trở đi. FP64 là định dạng độ chính xác kép dùng trong các phép tính khoa học và kỹ thuật; cuBLAS là thư viện xử lý phép toán ma trận trên GPU.
Tính năng mô phỏng FP64 trước đó được cung cấp dưới dạng tùy chọn dựa trên Ozaki-I trong CUDA Toolkit 13.0 Update 2. Ozaki-II được bổ sung ở phiên bản 13.4, còn 13.4.2 là bản cập nhật tiếp theo, được ghi là 13.4 Update 1.
NVIDIA công bố hiệu năng mô phỏng tối đa trên B200 là 175 TFLOPS với phép nhân ma trận thực DGEMM và 295 TFLOPS với phép nhân ma trận phức ZGEMM. Trên RTX PRO 6000 Blackwell Server Edition, các mức tương ứng là tối đa 45 TFLOPS và 70 TFLOPS. Cả bốn con số đều là mức tối đa của phép nhân ma trận mô phỏng.
Thuật toán 2M dùng cho phép nhân ma trận phức thường giảm số phép nhân ma trận thực từ bốn xuống còn hai. Trong tài liệu nghiên cứu về thuật toán 2M, NVIDIA Research cho biết khi kết hợp với Ozaki-II, phép nhân ma trận phức có thể được xử lý trong khoảng gấp đôi thời gian cần để nhân ma trận thực cùng kích thước.
Trong đường xử lý mô phỏng của cuBLAS, ma trận đầu vào được chuyển sang định dạng dấu phẩy cố định, sau đó được xử lý bằng các đơn vị tính toán của GPU và các kết quả trung gian được kết hợp lại. Tài liệu cuBLAS của NVIDIA mô tả phương pháp này cùng các điều kiện hỗ trợ.
Tính năng tự động điều chỉnh độ chính xác động tính số bit phần định trị cần thiết cho dữ liệu đầu vào. Nếu vượt giới hạn đã đặt, hệ thống chuyển sang phép tính FP64 gốc thay vì mô phỏng. Đường xử lý thực tế có thể thay đổi tùy dữ liệu đầu vào và yêu cầu độ chính xác.
CUDA Toolkit 13.4.2 cũng cải thiện việc cấp phát bộ nhớ làm việc cho mô phỏng: khi thiếu bộ nhớ, hệ thống có thể lấy thêm không gian từ nhóm bộ nhớ riêng của từng thiết bị. Thay đổi này nhằm giảm chi phí phát sinh do phải lặp lại việc cấp phát bộ nhớ cho từng handle.
NVIDIA cho biết trong cùng bản cập nhật, hiệu năng tối đa của ZGEMM trên GPU Rubin tăng tới 25%. Con số này chỉ áp dụng cho phép nhân ma trận phức, không thể hiện mức cải thiện thời gian chạy của các phép toán khác hay toàn bộ chương trình.
Thông lượng tối đa của phép nhân ma trận mô phỏng không đồng nghĩa với hiệu năng của toàn ứng dụng. Hiệu quả thực tế có thể thay đổi tùy tỷ trọng phép nhân ma trận trong tác vụ, điều kiện đầu vào và GPU được sử dụng.
NVIDIA từng báo cáo một trường hợp mô phỏng dựa trên Ozaki trước đây, trong đó Quantum ESPRESSO chạy nhanh hơn 1,5 lần so với thiết lập mặc định trên RTX PRO 6000 Blackwell Server Edition. Đây không phải kết quả đo trực tiếp Ozaki-II trên CUDA 13.4, theo bài viết kỹ thuật của NVIDIA về mô phỏng số dấu phẩy động trong cuBLAS.
Bản cuBLAS Patch Release 13.8.2 riêng biệt áp dụng cho CUDA Toolkit 13.4 Update 1 đã sửa lỗi hiếm gặp ở một số quy trình BLAS3 số phức sử dụng Ozaki-II. Lỗi có thể xảy ra khi tính tích vô hướng của các vectơ gần song song có độ lớn thành phần tương tự nhau, theo ghi chú phát hành bản vá cuBLAS.
Trong khi đó, ghi chú phát hành CUDA Toolkit 13.5.0 liệt kê lỗi hiếm gặp cùng loại liên quan đến Ozaki-II là vấn đề đã biết. Tính đến ngày 14, phiên bản mới nhất trong kho lưu trữ CUDA Toolkit của NVIDIA là 13.5.0, theo ghi chú phát hành CUDA Toolkit 13.5.
CUDA 13.5 mở rộng phạm vi áp dụng Ozaki-II sang một số phép toán hạng-k đối xứng và Hermitian. Đây là thay đổi mở rộng các phép toán được hỗ trợ, tách biệt với tính năng mô phỏng phép nhân ma trận phức được giới thiệu ở phiên bản 13.4.
Trong thử nghiệm động lực học phân tử BF16x9 trên B300 mà TokenPost từng đưa tin, phương pháp được sử dụng là mô phỏng FP32. Độ chính xác và đối tượng đo trong thử nghiệm đó khác với mô phỏng phép nhân ma trận FP64 lần này.

Comment 0