

 News
 Coin Information
 About us


 Add as a preferred source on Google
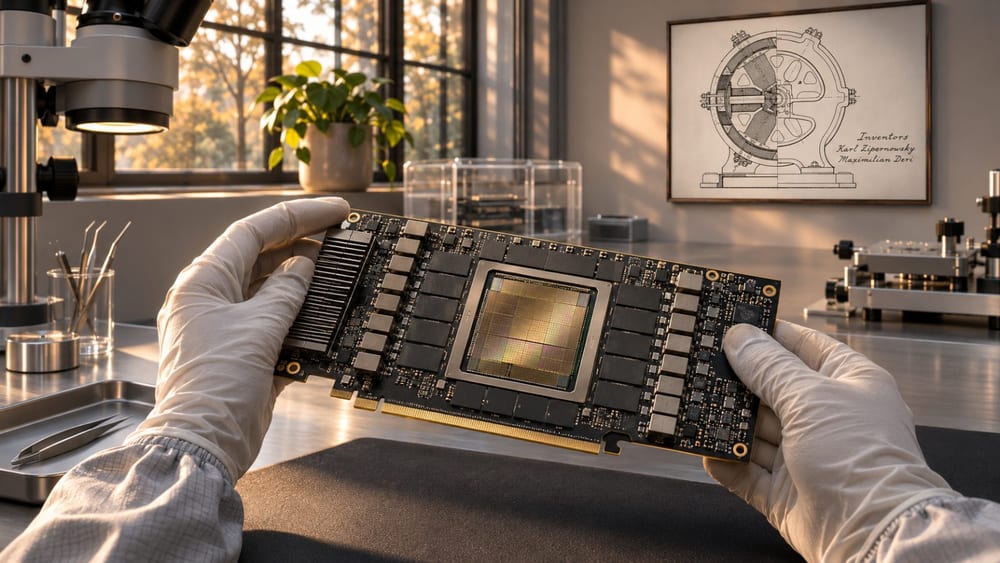
NVIDIA đã công bố công thức triển khai Dynamo cho 4 mô hình AI Hàn Quốc, kèm cấu hình GPU B200 và cách chạy hợp nhất hoặc tách rời theo từng mô hình.
NVIDIA (NVDA) cho biết trong bài đăng blog chính thức ngày 8 rằng hãng đã công bố công thức cho A.X K2 của SK Telecom (017670), K-EXAONE 2.0 của LG AI Research, Solar Open 2 của Upstage và Motif-3 của Motif Technologies.
Dynamo là khung suy luận mã nguồn mở dùng để phục vụ các mô hình lớn trên nhiều nút. Khung này điều phối việc định tuyến yêu cầu và liên lạc giữa các GPU, giúp chạy mô hình trên các tài nguyên tính toán phân tán.
NVIDIA cho biết các công thức có thể tăng hiệu năng tối đa gấp 2 lần với thiết lập mặc định. Tuy nhiên, blog không nêu thiết lập dùng để so sánh hay khối lượng công việc được đo, nên chưa thể khái quát con số này thành mức cải thiện hiệu năng cho từng mô hình trong cả bốn mô hình.
Công thức A.X K2 bố trí 8 GPU B200 cho cấu hình hợp nhất và 12 GPU cho cấu hình tách rời. Cấu hình hợp nhất dùng worker hợp nhất, còn cấu hình tách rời sử dụng các worker riêng để xử lý đầu vào và tạo đầu ra.
Danh sách công thức Dynamo và tài liệu từng mô hình nêu cấu hình 4 và 8 GPU B200 cho K-EXAONE 2.0 và Solar Open 2. Công thức Motif-3 hướng dẫn dùng 2 GPU cho cấu hình hợp nhất và 8 GPU cho cấu hình tách rời.
Cấu hình hợp nhất xử lý đầu vào và tạo đầu ra trong cùng một cấu hình. Với cấu hình tách rời, hai công việc này được phân bổ cho các tài nguyên GPU riêng biệt.
Tài liệu K-EXAONE 2.0 công bố kết quả dựa trên 1.805 bản ghi truy vết hội thoại. Cấu hình hợp nhất với 4 GPU B200 đạt tốc độ đầu ra trung vị 51,4 token/giây cho người dùng và độ trễ trung vị đến token đầu tiên là 291 ms.
Cấu hình tách rời với 8 GPU B200 đạt tốc độ đầu ra trung vị 54,9 token/giây và độ trễ trung vị đến token đầu tiên là 2.230 ms. Mức đồng thời của hai cấu hình lần lượt là 7 và 14.
Tài liệu đã loại khỏi thống kê 38 yêu cầu vượt quá độ dài ngữ cảnh tối đa 262.144 token. Số GPU và mức đồng thời giữa hai cấu hình cũng khác nhau, vì vậy không thể xem kết quả là phép so sánh trực tiếp trong cùng điều kiện.
Tài liệu Solar Open 2 cho biết môi trường vLLM mặc định của Dynamo 1.4.1 không hỗ trợ mô hình, nên cần một ảnh môi trường chạy được cấu hình riêng. Do đó, công thức này cũng bao gồm điều kiện chuẩn bị môi trường chạy.
Công thức Motif-3 được đánh dấu là đang trong giai đoạn thử nghiệm. Tài liệu cho biết bảng hiệu năng sử dụng độ dài chấp nhận token tổng hợp để đo, chứ không phải kết quả giải mã suy đoán thực tế.
Các điều kiện triển khai trong tài liệu A.X K2 gồm cụm Kubernetes đã cài nền tảng Dynamo và bộ nhớ dùng chung. Cấu hình tách rời cũng cần tài nguyên InfiniBand để truyền dữ liệu qua NIXL và UCX.
Bộ Khoa học và Công nghệ Thông tin và Truyền thông Hàn Quốc (Ministry of Science and ICT) giới thiệu bốn mô hình này là sản phẩm của các doanh nghiệp tham gia chương trình phát triển mô hình nền tảng AI độc lập. Tài liệu mới của NVIDIA tập trung vào thiết lập triển khai các mô hình đó bằng Dynamo.
Thông báo lần này đề cập đến việc công bố công thức triển khai theo từng mô hình, không công bố quy mô ứng dụng vận hành thực tế tại khách hàng. Các số liệu hiệu năng cũng cần được xem xét cùng phần cứng và điều kiện đo của từng mô hình.
Trước đây, TokenPost đã đưa tin về quy trình AICR để triển khai và xác minh Dynamo trên cụm Kubernetes hiện có. Bài viết trước tập trung vào cấu hình hạ tầng và quy trình xác minh; thông báo lần này nêu cách bố trí GPU và thiết lập suy luận cho bốn mô hình AI Hàn Quốc.



Comment 0