

 News
 Coin Information
 About us


 Add as a preferred source on Google
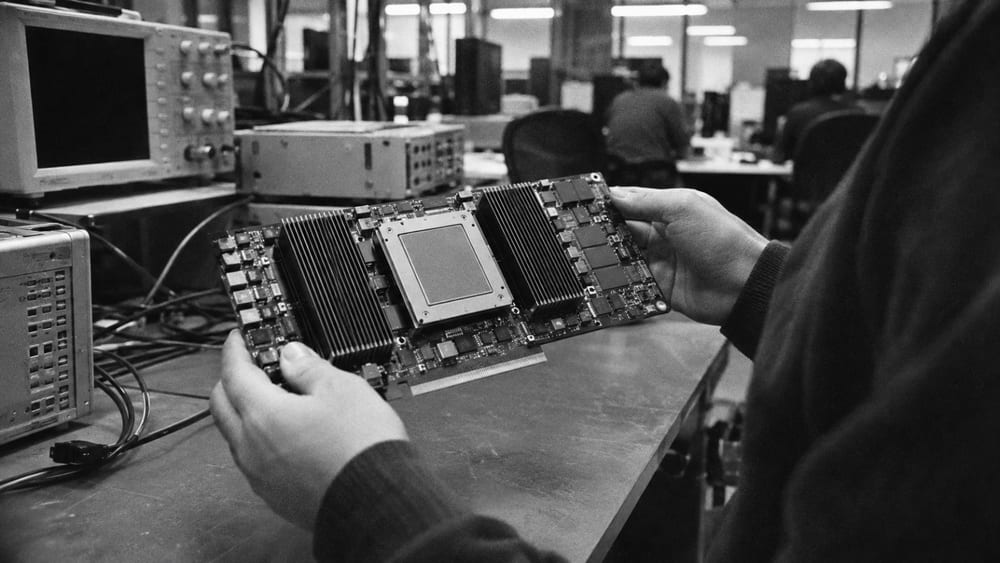
MLCommons công bố 250 kết quả thử nghiệm MLPerf Training v6.1, ghi nhận từ 153 hệ thống. Các hạng mục đánh giá mới gồm huấn luyện hệ thống gợi ý và hậu huấn luyện mô hình ngôn ngữ lớn (LLM) cho tác vụ phát triển phần mềm.
Trong thông cáo phát lúc 1 giờ ngày 17 (giờ Hàn Quốc), MLCommons cho biết 24 tổ chức đã tham gia đợt thử nghiệm. Trong số các hệ thống được ghi nhận, 57 hệ thống (37%) hoạt động trên nền tảng đám mây.
Tỷ lệ hệ thống đám mây tăng so với mức 29% của phiên bản trước, v6.0. Kết quả lần này cũng có các hệ thống sử dụng số lượng bộ tăng tốc lớn và những tác vụ huấn luyện mới.
MLPerf Training đo thời gian cần để một hệ thống huấn luyện bằng mô hình và dữ liệu được quy định, cho đến khi đạt chất lượng mục tiêu. Mô hình, dữ liệu và ngưỡng chất lượng khác nhau giữa các bài thử, vì vậy không thể xem 250 kết quả như một bảng xếp hạng hiệu năng duy nhất.
Quy định benchmark phân biệt Closed division và Open division, đồng thời phân loại hệ thống theo khả năng mua hoặc thuê. MLCommons cho biết thời gian huấn luyện có thể dao động; mức biến động của các benchmark không dùng hình ảnh vào khoảng ±5%. Hướng dẫn MLPerf Training cũng nêu các điều kiện so sánh riêng cho từng bài thử.
Bài thử hệ thống gợi ý DLRMv4-HSTU thay thế benchmark DLRM-dcnv2 trước đây. Bài thử dùng cấu trúc HSTU để xử lý tuần tự lịch sử hành vi của người dùng và đo thời gian huấn luyện mô hình gợi ý.
Bài thử này sử dụng dữ liệu Yambda-5B, gồm lịch sử sử dụng dịch vụ âm nhạc với khoảng 4,79 tỷ lượt tương tác.
Bài thử hậu huấn luyện mới đo thời gian cần để huấn luyện Qwen3.5-397B-A17B thực hiện các tác vụ phát triển phần mềm. Mô hình thử giải quyết tác vụ trong môi trường thực thi tách biệt, sau đó tiếp tục được huấn luyện dựa trên kết quả. Chất lượng mục tiêu được đặt ở mức “0,69 pass @ 4”.
Bài thử áp dụng phương pháp GRPO (Group Relative Policy Optimization). Phương pháp này cập nhật mô hình bằng cách so sánh phần thưởng tương đối giữa nhiều lần thử. Phạm vi của bài thử khác với việc đánh giá chất lượng của mọi tác vụ mà một tác nhân AI thực hiện trong dịch vụ thực tế.
Trước đó, MLCommons đã công bố báo cáo về thông lượng và thời gian phản hồi ở giai đoạn suy luận. MLPerf Training v6.1 đo thời gian đạt mục tiêu huấn luyện, không đo tốc độ suy luận.
Trong số các hệ thống tham gia, 12 hệ thống sử dụng từ 1.000 bộ tăng tốc trở lên. Hệ thống lớn nhất có 10.240 bộ tăng tốc. GPU thế hệ Rubin của Nvidia (NVDA) và TPUv7 Ironwood của Google lần đầu xuất hiện trong kết quả MLPerf Training.
Google Cloud cho biết trong thông báo riêng rằng 8.192 TPU Ironwood đạt chất lượng mục tiêu của tác vụ tiền huấn luyện DeepSeek-V3 trong 1,70 phút. Với 640 TPU Ironwood, bài thử hậu huấn luyện Qwen mất 18,02 phút. Hai kết quả thuộc các tác vụ và sử dụng số lượng bộ tăng tốc khác nhau.
AMD (AMD) cho biết trong tài liệu bổ sung của đơn vị tham gia rằng hiệu năng huấn luyện Llama với 8 bộ tăng tốc MI350X và MI355X cải thiện trung bình 19% so với v6.0. Nvidia cho biết trong điều kiện sử dụng cùng số GPU, Vera Rubin NVL72 nhanh hơn GB300 NVL72 tối đa 2 lần ở một số bài thử.
Các số liệu này là những điểm mà từng công ty nhấn mạnh trong kết quả dự thi của mình. MLCommons nêu rõ phần mô tả bổ sung của các công ty không đại diện cho quan điểm của hiệp hội. Tài liệu bổ sung trình bày kết quả và giải thích của từng đơn vị tham gia.
Bảng kết quả chính thức cung cấp dữ liệu theo mô hình, đơn vị tham gia, số lượng bộ tăng tốc và cấu hình hệ thống. Khi xem kết quả huấn luyện AI, cần đối chiếu các hệ thống trong cùng bài thử và điều kiện tương ứng.

Comment 0